
Elke week krijgen we dezelfde vraag: we hebben Microsoft Copilot, waarom zouden we onze requirements-extractie en -review daar niet gewoon in configureren?
Het korte antwoord: nee. Niet als nauwkeurigheid, auditeerbaarheid en datasoevereiniteit je iets waard zijn.
In een echt gesprek geven we natuurlijk meer context — en dat langere antwoord is waar dit artikel over gaat. Horizontale AI-tools — generieke assistenten die iedereen helpen met e-mails schrijven, vergaderingen samenvatten en code debuggen — sluiten fundamenteel niet aan op de eisen van Systems Engineering (SE).
Zelfs met aangepaste prompts, plugins en zorgvuldige configuratie stuiten ze op een structureel plafond dat verticale oplossingen zoals Basewise specifiek zijn ontworpen om te doorbreken.
01 | Het "manusje-van-alles"-probleem
Generieke assistenten hebben een uitzonderlijk brede dataset nodig om te functioneren; daarom zijn de modellen achter Copilot getraind op data van het hele internet. Ze weten daardoor van alles een beetje, maar zijn nergens expert in.
Modellen & Controle
Alle frontier foundation models worden getraind als generalisten. Onderzoek van DeepMind en EPFL toont aan dat multi-task fine-tuning onvermijdelijk leidt tot beperkte capaciteit en negatieve taakinterferentie — dezelfde gewichten die geoptimaliseerd zijn voor juridisch redeneren, creatief schrijven en open gesprekken kunnen onmogelijk tegelijkertijd de diepgang bereiken die veiligheidskritische engineeringstandaarden vereisen [1].
Wij pretenderen niet aan deze basis te ontsnappen. We gebruiken dezelfde basismodelfamilie als Copilot — maar daar houdt de overeenkomst op. Copilot is een one-size-fits-all consumenten-endpoint, beheerd via Microsofts backend-routing, capaciteitsmanagement en ondoorzichtige parameterschema's. Die stack is onderhevig aan wijzigingen in contextwindows, modellen, tokengebruik en andere parameters die de output zonder waarschuwing veranderen.
Basewise beheert de volledige stack. Wij controleren de endpoints, de modelvarianten en de onderliggende inferentieparameters rechtstreeks. Die controle betekent dat het gedrag van ons systeem deterministisch en afstembaar is — niet onderhevig aan de kwaliteitsschommelingen die ontstaan wanneer een gedeelde cloud-backend capaciteit terugschroeft of stilzwijgend modelversies verwisselt.
Binnen die gecontroleerde omgeving kooien we de generalist in: deterministische INCOSE-guardrails draaien vóórdat er ook maar één token het model bereikt; projectspecifieke retrieval verankert elk antwoord in jouw contract, standaarden en verificatiehistorie; confidence scoring dwingt het systeem om onzekerheid te melden in plaats van te hallucineren; en een smalle operationele scope stript alles weg behalve het redeneervermogen dat nodig is voor de engineeringtaak in kwestie.
Waar Copilot je dus een ruwe generalist met een variabele backend geeft, geeft Basewise je een gespecialiseerde expert die opereert in een gecontroleerde omgeving.
Het effect van generieke versus geëngineerde output
In Systems Engineering is precisie niet-onderhandelbaar. Een requirement als "het systeem moet snel reageren op overstroomcondities" is slecht geformuleerd, niet-verifieerbaar, niet-testbaar en potentieel contractueel gevaarlijk. Generieke AI markeert het misschien als "vaag", maar alleen een systeem dat getraind is op INCOSE- en IEEE 29148-standaarden kan uitleggen waarom het niet-verifieerbaar is, de specifieke regel citeren (ontbrekende meetbare drempelwaarde) en een compliant herformulering voorstellen. Bovendien levert alleen een geëngineerd systeem die analyse consistent af — en waarschuwt het wanneer het ambiguïteit tegenkomt.
Analistenbureau Gartner voorspelt dat deze verticale specialisatie steeds belangrijker wordt voor effectieve inzet van AI in enterprise-oplossingen: volgens hun prognose bevat 40% van de enterprise-applicaties dit jaar taakspecifieke AI-agents [2].
02 | De compliance- en auditeerbaarheidskloof: Copilot kan zijn werk niet laten zien
In gereguleerde sectoren — zorg, financiën, verzekeringen en ja, grootschalige infrastructuur — moet elke beslissing jaren later nog traceerbaar zijn. Een systeem dat zijn conclusies niet kan verklaren is niet alleen onbruikbaar; het gebrek aan verklaarbaarheid vormt op zichzelf een compliance-gat.
De auditlogs van Microsoft Copilot leggen prompts en eindantwoorden vast en leveren daarmee een deel van het vereiste spoor. Maar de log is niet ontworpen om de redeneerstappen en tussentijdse data van het model te bevatten — precies de context die nodig is wanneer een audit onderzoekt waarom een requirement is goedgekeurd.
Voor Systems Engineering is dit een dealbreaker. INCOSE-standaarden, ISO/IEC/IEEE 15288 en projectspecifieke contractuele kaders vereisen traceerbaarheid. Wanneer Basewise's Requirements Quality Analyser (RQA) een requirement als ambigu markeert, verwijst het naar een specifieke regelcode, toont het de exacte tekst die de melding veroorzaakte en genereert het een audit-klaar rapport. Elke bevinding is verklaarbaar en elke beslissing is traceerbaar.
Audit trails kunnen geen bijzaak zijn — ze zijn onderdeel van de architectuur. Onze output is ontworpen om de toets van klanten, toezichthouders en rechtbanken te doorstaan.
03 | Datasoevereiniteit: de EU-stack is niet-onderhandelbaar
Iets wat de meeste enterprise AI-kopers over het hoofd zien: Copilot in Europa draaien garandeert niet dat je data in Europa blijft. Microsofts eigen documentatie erkent dat Copilot verzoeken kan routeren naar de primaire tenant-locatie — wat betekent dat de prompt van een Europese gebruiker in de Verenigde Staten verwerkt kan worden als daar de home region van de tenant staat. Voor infrastructuurprojecten die vallen onder de AVG, de EU AI Act en nationale aanbestedingswetgeving is dit onacceptabel.
Zelfs met multi-geo-configuraties garandeert Copilot geen dataverwerking in dezelfde regio als de mailbox of SharePoint-site van de gebruiker. En fundamenteel blijf je afhankelijk van de infrastructuur van een Amerikaanse techgigant, onderworpen aan de CLOUD Act en ondoorzichtige subverwerkers. Dit ligt niet aan slecht presteren van Microsoft — het is simpelweg de wetgeving waaraan het onderworpen is.
Basewise heeft een bewuste, strategische keuze gemaakt: wij stappen volledig af van de Microsoft-stack. We zitten middenin deze transitie, waarbij we onze inference verplaatsen van hyperscaler-stacks naar een soevereine EU-provider.
Binnenkort opereren we op een volledig datasoevereine EU-stack met eigen technologie en nul afhankelijkheden van grote techleveranciers. Jouw data verlaat nooit de Europese jurisdictie. In veel projecten is dat een wettelijke eis.
04 | Hallucinaties & confidence-kalibratie
De gevaarlijkste van alle fouten is dat AI even zelfverzekerd klinkt of het nu gelijk heeft of niet.
- Een arXiv-studie van juni 2026, gebaseerd op echte rechtbankdossiers, vond meer dan 1.000 zaken met door AI verzonnen citaties — een aantal dat jaar op jaar groeit [3].
- De Stanford HAI AI Index 2026 registreerde sycofantie-gedreven hallucinatiepercentages tussen 22% en 94% bij 26 frontier-modellen op juridische taken [4].
In Systems Engineering kan een gehallucineerde regelgevingsclaim of een verzonnen verificatiestandaard een infrastructuurproject van €500 miljoen laten ontsporen, juridische claims veroorzaken en zelfs tot gevaarlijke situaties leiden.
Copilot heeft geen ingebouwde validatie voor regelgevingsnauwkeurigheid. Het weet niet welke versie van een bouwbesluit van toepassing is op jouw Nederlandse spoorproject. Het kan niet beoordelen of een verificatiemethode voldoet aan jouw specifieke EMVI-contract. En bij onzekerheid meldt het die onzekerheid niet vanzelf — het gokt. Door de onderliggende technologie garandeert zelfs het toevoegen van deze context aan een knowledge store geen correcte toepassing.
Basewise pakt dit aan met gespecialiseerde retrieval engineering, gestructureerd redeneren, bronvermelding en confidence scoring. Wanneer onze Requirements Evidence Finder (REF) onvoldoende bewijs vindt voor een requirement, zegt hij dat. Als onze applicaties niet zeker zijn van wat ze vinden, melden ze dat aan jou en betrekken ze mensen bij de review.
De output is niet ondoorzichtig: hij is een accurate weergave van de analyse en escaleert naar een mens wanneer dat nodig is.
05 | INCOSE-compliance is geen prompt — het is een ontologie
Je kunt je niet naar INCOSE-compliance prompten. De INCOSE Guide to Writing Requirements, ISO 29148 en het SE Handbook vormen samen een domeinspecifieke ontologie — een gestructureerde manier van denken over noodzakelijkheid, verifieerbaarheid, consistentie en traceerbaarheid, waar decennia en vele experts aan te pas kwamen om te formaliseren.
Onderzoek dat AI-ondersteunde requirement-evaluatie vergelijkt met beoordeling door menselijke experts concludeert dat AI-tools weliswaar consistente en snelle voorlopige beoordelingen kunnen leveren — vooral voor syntactische en structurele kwaliteitsattributen — maar dat expertoordeel essentieel blijft voor contextuele interpretatie, het oplossen van ambiguïteit en het afwegen van trade-offs [5].
De sleutel is om dat expertoordeel in te bedden in een multi-agent-architectuur — en niet één generiek model te vragen om te doen alsof het Systems Engineering begrijpt. Basewise heeft het reviewproces geëngineerd als een gespecialiseerd framework dat taken toewijst aan specifieke modellen en agents traint voor afgebakende functies:
- één agent extraheert requirements uit contracten en standaarden;
- een tweede past deterministische INCOSE-regels toe;
- een derde voert semantische analyse uit op ambiguïteit en trade-offs;
- en een vierde vindt en scoort bewijs in projectdata.
Elke agent opereert binnen een smalle, gecontroleerde scope met taakspecifieke parameters — zo ontstaat een systeem, in plaats van één enkele agent die een review uitvoert.
Onderzoek naar gespecialiseerde sectoren ondersteunt de conclusie dat deze kloof niet met betere prompts te overbruggen is. De structurele mismatch tussen het operationele ontwerp van generieke AI-frameworks en de werkelijke eisen van gereguleerde sectoren is een mismatch by design.
De markt heeft al gekozen
De verschuiving van horizontaal naar verticaal voor nichetoepassingen is niet nieuw en geen theorie — de markt kent er inmiddels genoeg voorbeelden van. Gartner voorspelt dat de agentic AI-markt in 2035 een omvang van $450 miljard bereikt, waarbij domeinspecifieke implementaties de generieke uitrol overtreffen [2].
Systems Engineering volgt dezelfde koers. De vraag is niet óf je AI gaat inzetten voor requirements management — de vraag is of je de tool kiest die voor jouw domein is gebouwd, of een generalist probeert te dwingen het werk van een specialist te doen.
06 | Basewise: AI gebouwd voor Systems Engineering, door Systems Engineers
Toen we Basewise begonnen, wilden we niet zomaar de zoveelste chatbot bouwen. We wilden een hoogwaardig, betrouwbaar en doelgericht systeem leveren dat Systems Engineering naar een hoger niveau tilt. Basewise moet engineers tijd besparen, de kwaliteit van projecten verhogen en SE-best-practices in meer projecten verankeren.
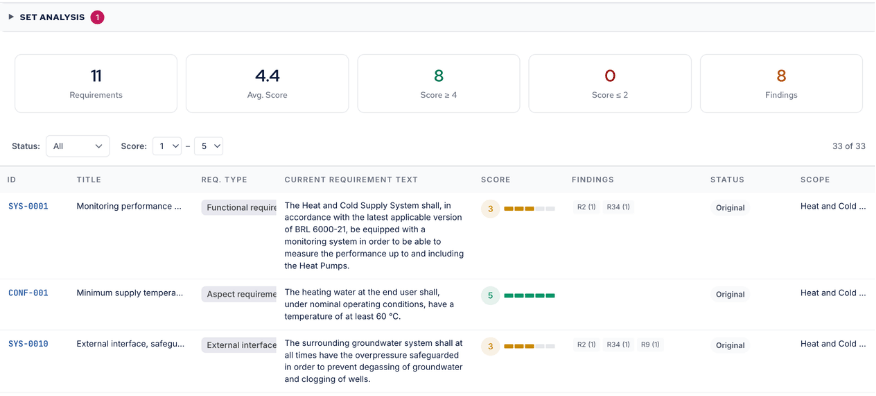
Onze huidige oplossingen richten zich op de kerngebieden van het SE-traject:
- DRE zet contracten van 500 pagina's in enkele minuten om in gestructureerde requirements-tabellen.
- RQA combineert deterministische regels met LLM-semantiek om ambiguïteit, absolute termen en samengestelde requirements op te sporen — inclusief INCOSE-compliant verbetervoorstellen.
- REF zet drie AI-agents in om bewijs voor requirements te vinden, te beoordelen en te scoren, afgestemd op jouw projectfase.
- Knowledge Chat is jouw getrainde, SE-specifieke assistent — geen generalist die doet alsof hij jouw domein begrijpt.
- Volledig datasoevereine EU-stack — eigen technologie, nul afhankelijkheden van big tech, klaar voor AVG en EU AI Act.
We hebben inmiddels 50.000+ requirements verwerkt en 10.000+ verificaties uitgevoerd. Onze klanten rapporteren tijdwinst en kwaliteitsverbetering in elk project dat ze draaien.
07 | De conclusie
Alle punten op een rij, dan is dit de uitkomst:
- Je kúnt Copilot vragen je requirements te reviewen.
- Je kúnt uitgebreide prompts over INCOSE-standaarden schrijven om output te krijgen.
- Je kúnt aannemen dat je data in Europa blijft en dat de output auditeerbaar is.
Maar generieke horizontale assistenten zijn by design niet gebouwd om de juiste uitkomst te leveren. Output zal variëren, in de loop van de tijd veranderen en moeilijk te verklaren zijn. Uiteindelijk zet die aanpak het SE-proces en je projecten op het spel.
En daarom heb je AI nodig die vanaf de basis voor SE is gebouwd. Dat is Basewise.
Bronnen
[1] Karimi Mahabadi, R., Ruder, S., Dehghani, M. en Henderson, J. (2021) 'Parameter-efficient Multi-task Fine-tuning for Transformers via Shared Hypernetworks', arXiv preprint, arXiv:2106.04489. Beschikbaar op: https://arxiv.org/abs/2106.04489 (Geraadpleegd: 2 juli 2026).
[2] Gartner (2025) 'Gartner Predicts 40% of Enterprise Apps Will Feature Task-Specific AI Agents by 2026', Gartner Newsroom, 26 augustus. Beschikbaar op: https://www.gartner.com/en/newsroom/press-releases/2025-08-26-gartner-predicts-40-percent-of-enterprise-apps-will-feature-task-specific-ai-agents-by-2026-up-from-less-than-5-percent-in-2025
[3] Liu, Y., Stammbach, D. en Henderson, P. (2026) 'Who Checks the Citations? Benchmarking Legal Hallucination Detection', arXiv preprint, arXiv:2606.21155. Beschikbaar op: https://arxiv.org/abs/2606.21155 (Geraadpleegd: 2 juli 2026).
[4] Stanford University Human-Centered Artificial Intelligence (2026) AI Index Report 2026. Stanford HAI. Beschikbaar op: https://hai.stanford.edu/ai-index-report (Geraadpleegd: 2 juli 2026).
[5] arXiv (2026) 'AI-Assisted Requirements Engineering', arXiv preprint, arXiv:2604.15222. Beschikbaar op: https://arxiv.org/abs/2604.15222 (Geraadpleegd: 2 juli 2026).
Waarom brede AI niet volstaat voor eisenmanagement
Risico's van AI bij het extraheren van eisen: hallucinaties en aannames
%20doc%20=%20fitz.open(pdf_path)%20full_text%20=%20%20for%20page%20in%20doc%20full_text%20+=%20page.get_text()%20return%20full_text%20%23%20Gebruik%20%23%20print(extract_text_from_p.png)