
AI in Systems Engineering hoeft niet perfect te zijn om nuttig te zijn. Wel moet het betrouwbaar genoeg zijn om in de praktijk op te vertrouwen. Dit is hoe we dat technisch borgen.
Dat is de echte zorg voor de meeste systems engineers. AI kan relatief makkelijk vloeiende output produceren, maar die output consistent, correct en bondig krijgen is de echte uitdaging. Dat weegt des te zwaarder omdat het proces omtrent eisen, verificatie en analyses onderhevig zijn aan compliance-checks en daarmee vormt hallucinatie een reëel risico voor het proces.
Basewise claimt niet hallucinatie-vrij te zijn, en we garanderen niet dat AI-output nooit fout zal zijn. Dat zou in een systems-engineeringcontext geen geloofwaardige claim zijn. Wat we wél claimen is praktischer: Basewise is zo ontworpen dat het hallucinatierisico tot een zeer hoog betrouwbaarheidsniveau wordt beheerst, zodat engineers de handmatige inspanning fors kunnen terugbrengen terwijl de eindcontrole blijft waar die hoort.
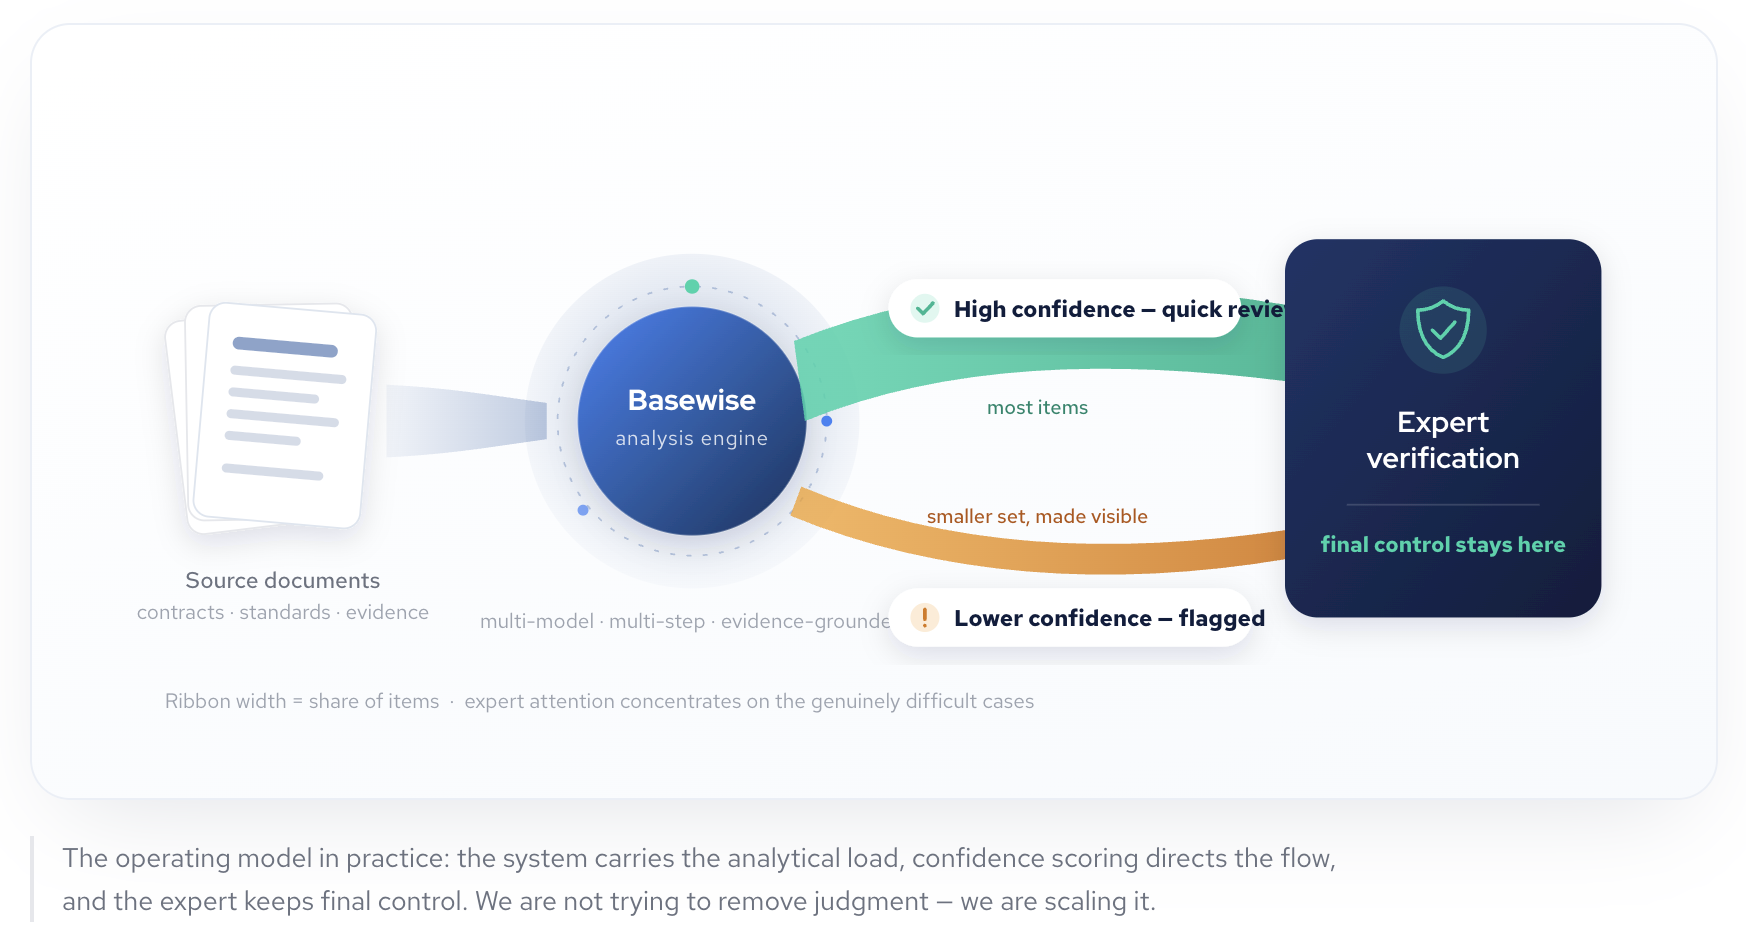
Voor systems-engineeringteams is dat het bruikbare operating model. We proberen het oordeel niet weg te nemen. We proberen de handmatige last rond het werk te verminderen, terwijl de output gegrond, uitlegbaar en controleerbaar blijft. Onze missie is in feite: menselijke expertise opschalen en inzetten, en verspilling beperken.
Waarom hallucinatie een serieus probleem is in Systems Engineering
Systems Engineering is bijzonder kwetsbaar voor hallucinatie omdat betekenis sterk contextafhankelijk is. Eisen hangen vaak af van contracttaal, stakeholderintentie, normen, faseafhankelijke verwachtingen en raakvlakken met andere delen van het systeem. Kleine interpretatiefouten kunnen doorwerken in eisen, interface (of raakvlak)-afspraken, verificatieclaims of zelfs safety-argumentatie en die fouten kunnen later kostbaar zijn om recht te zetten.
Daarom behandelt Basewise AI-output als een voorstel, niet als bewijs.
Om output te kunnen vertrouwen in een engineering-workflow, moet aantoonbaar zijn:
- Welke bronnen zijn gebruikt.
- Welke aannames zijn gedaan.
- Hoe het resultaat in de baseline past.
- Welke review- en acceptatiestappen zijn doorlopen.
Kort gezegd: vertrouwen mag alleen reiken tot het niveau waarop output te verifiëren, te herleiden en te auditen is. Alles daarboven vraagt nog steeds expliciet menselijk toezicht.
Onze betrouwbaarheidsfilosofie: hybride, gelaagd en controleerbaar
Basewise hanteert een hybride betrouwbaarheidsaanpak. We leunen niet op één prompt, één model of één controle om het hallucinatierisico laag te houden. De safeguards en checks zijn te complex om los van elkaar goed te werken. Betrouwbaarheid komt voort uit de manier waarop ze samen werken.
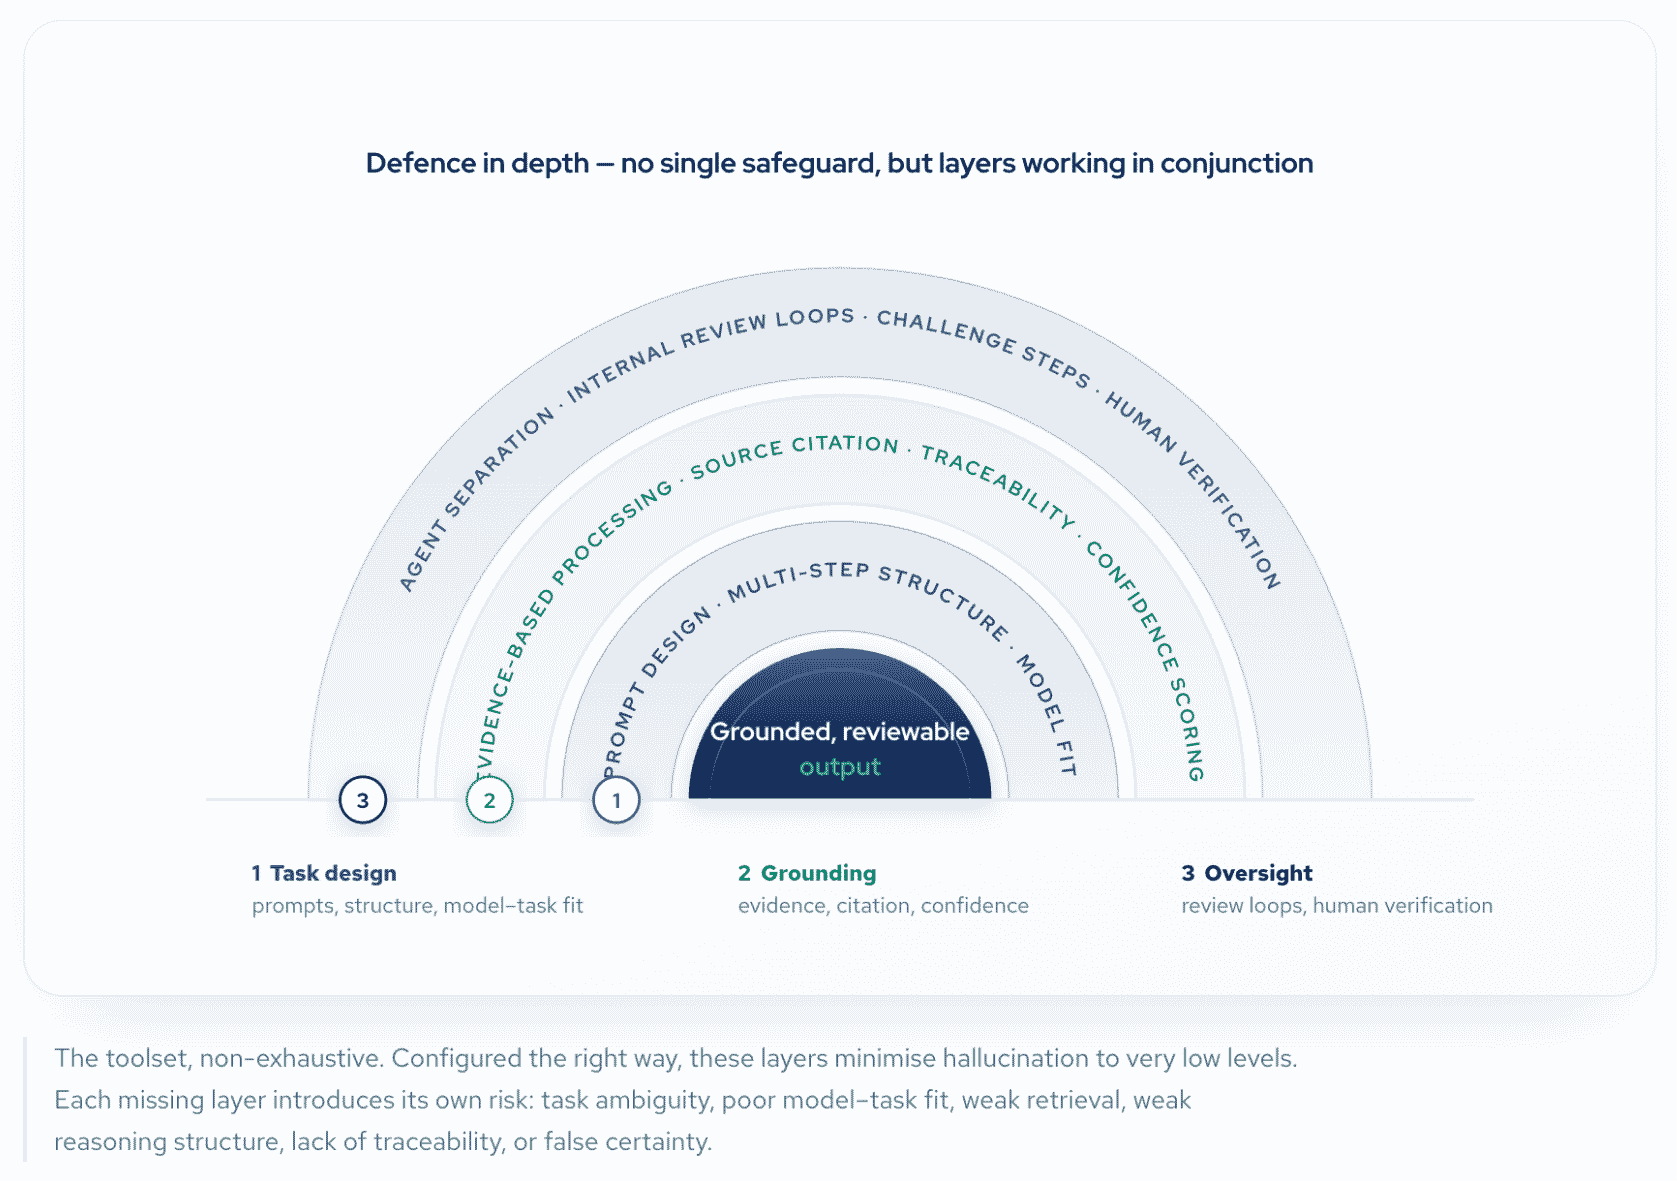
De safeguards werken samen, niet in rangorde
Het is verleidelijk te vragen welke safeguard het belangrijkst is. In werkelijkheid is geen van alle op zichzelf voldoende.
Prompts afgestemd op de taak én het model
Alle prompts in Basewise zijn app-specifiek en model-specifiek. Ze worden afgestemd via uitgebreide variantietests en volgen gestructureerde paden om te verzamelen, analyseren, interpreteren, scoren en beslissen.
Dat is belangrijk omdat veel hallucinatieproblemen beginnen bij taakambiguïteit. Laat de prompt te veel ruimte voor interpretatie, dan kan het model analyse, herschrijven, aannames maken en beslislogica door elkaar gaan halen op een manier die later moeilijk te reviewen is.
Basewise voorkomt dat door in elke applicatie multi-step-prompts te gebruiken. Sommige workflows zijn ook multi-agent, maar zelfs waar dat niet zo is, wordt de taak nog steeds opgedeeld in gecontroleerde stappen in plaats van als één ongebonden verzoek afgehandeld.
Modelkeuze op basis van geschiktheid, niet op formaat alleen
Grotere modellen zijn niet altijd beter. Bij sommige engineering-taken kan een kleiner model deterministischer, gerichter en minder geneigd zijn zich te laten afleiden door onnodige redeneerpaden.
Basewise gebruikt meerdere modellen, elk getest op zijn doel en elk anders geïnstrueerd afhankelijk van het modeltype. We routeren taken naar verschillende modellen:
- een groter model voor interpretatie, redeneren of complexere bewerkingen
- een kleiner model voor determinisme, snelheid en strakkere taakdiscipline
De regel is simpel: outputkwaliteit eerst, kosten daarna. Verschillende onderdelen van dezelfde app kunnen ander gedrag nodig hebben. Een goed engineering-AI-systeem moet niet elke taak behandelen alsof die dezelfde soort intelligentie vereist.
Bewijs en retrieval zijn cruciaal, zeker in onze verificatie tool REF.
Voor REF in het bijzonder is retrieval geen dunne toevoeging. Het is een kernonderdeel van het betrouwbaarheidsmodel.
REF is sterk gegrond in door de gebruiker aangeleverde data, en de retrieval-pijplijn is ontworpen voor gevallen waarin gebruikers zeer grote documentsets aanleveren, soms meer dan een gigabyte, waar detail telt. Er is net zoveel engineering in de retrieval-mechanismen gegaan als in de prompting en het modelgebruik.
Basewise gebruikt een op maat gemaakte engine met dynamische zoekstrategieën, reviewpaden, escalatielogica, confidence scoring en een analysetrace. Het proces is ontworpen om dicht bij het oorspronkelijke bewijs te blijven, in plaats van het model te laten afdrijven naar niet-onderbouwde synthese.
Ook hier telt multi-pass review. Het ophalen en beoordelen van bewijs wordt via meer dan één stap gereviewd om bias en variantie te verminderen, vooral als de interpretatie niet eenduidig is.
Confidence scoring
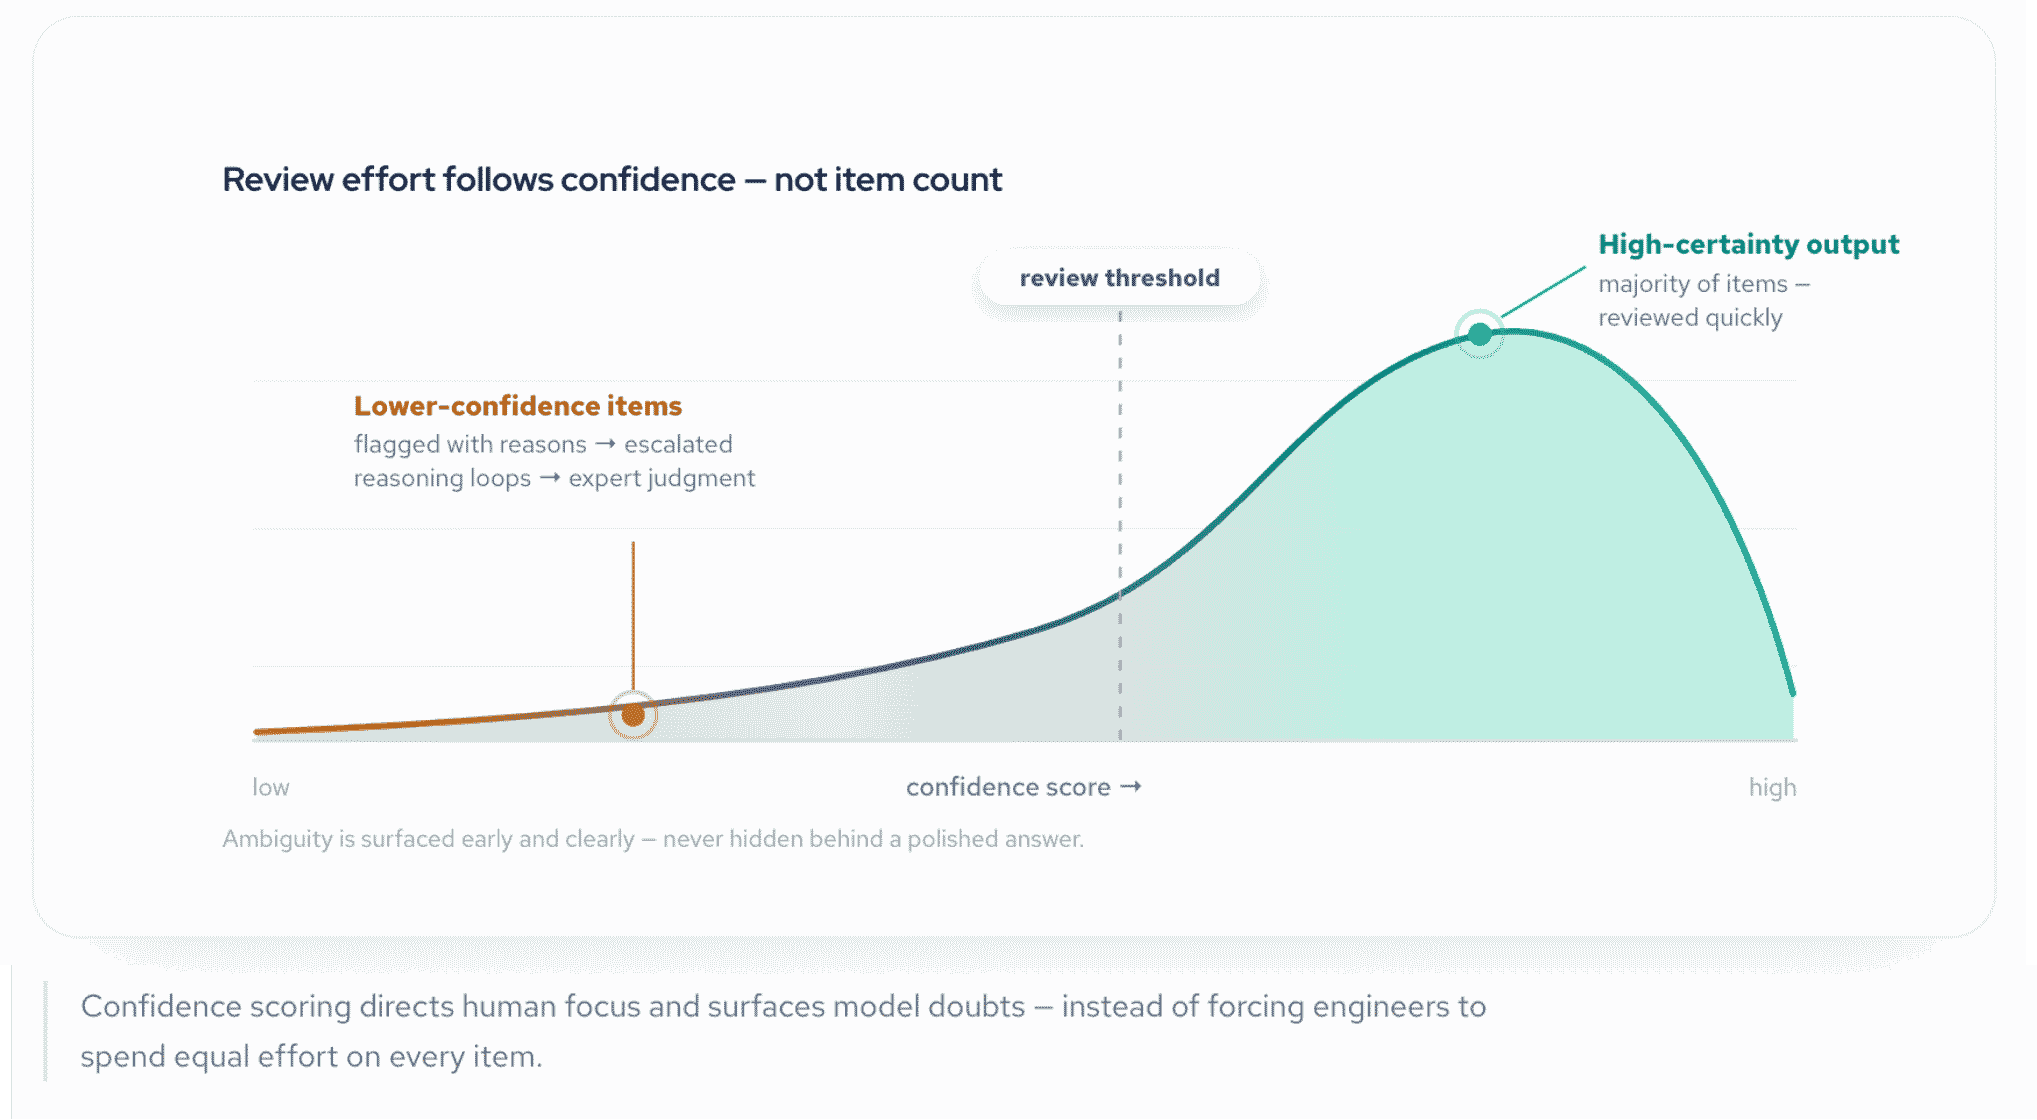
Confidence scoring werkt hand in hand met bewijs en traceerbaarheid. Het helpt engineers snel te zien waar de output goed onderbouwd is en waar het bronmateriaal ambiguer is.
Een goede review-workflow zou engineers niet moeten dwingen evenveel moeite aan elk item te besteden. Items met hoge zekerheid kunnen meestal snel worden gereviewd. Items met lagere zekerheid verdienen meer aandacht. Basewise maakt dat onderscheid zichtbaar via confidence scoring en leesbare analyse-output.
Agentscheiding waar nodig
Sommige taken kunnen beter worden opgesplitst in afzonderlijke jobs. Waar nodig gebruikt Basewise agentscheiding om taakvertroebeling te verminderen en het risico te beperken dat analyse, interpretatie, scoring en beslislogica door elkaar gaan lopen. Dit is vooral nuttig wanneer de ene stap het resultaat van een andere moet uitdagen of verifiëren.
Het gaat niet om complexiteit om de complexiteit. Het gaat erom elk deel van de redeneerpijplijn gericht en controleerbaar te houden.
Menselijke review blijft onderdeel van het ontwerp
Basewise ondersteunt zowel meer autonome als human-in-the-loop-workflows. In beide gevallen bevelen we menselijke verificatie aan.
Dat is niet omdat de output zwak is. Het is omdat engineering-verantwoordelijkheid nog steeds telt. In systems engineering is het doel niet om de expert eruit te halen. Het doel is de handmatige inspanning op de eenvoudige gevallen te verminderen en experttijd te reserveren voor de randgevallen en oordeelskwesties.
Hoe dit werkt in elke applicatie
De betrouwbaarheidscontroles zijn gedeeld over het hele platform, maar worden in elke app anders toegepast, omdat de risico's verschillen.
Eisen extractie zonder de bron te verliezen
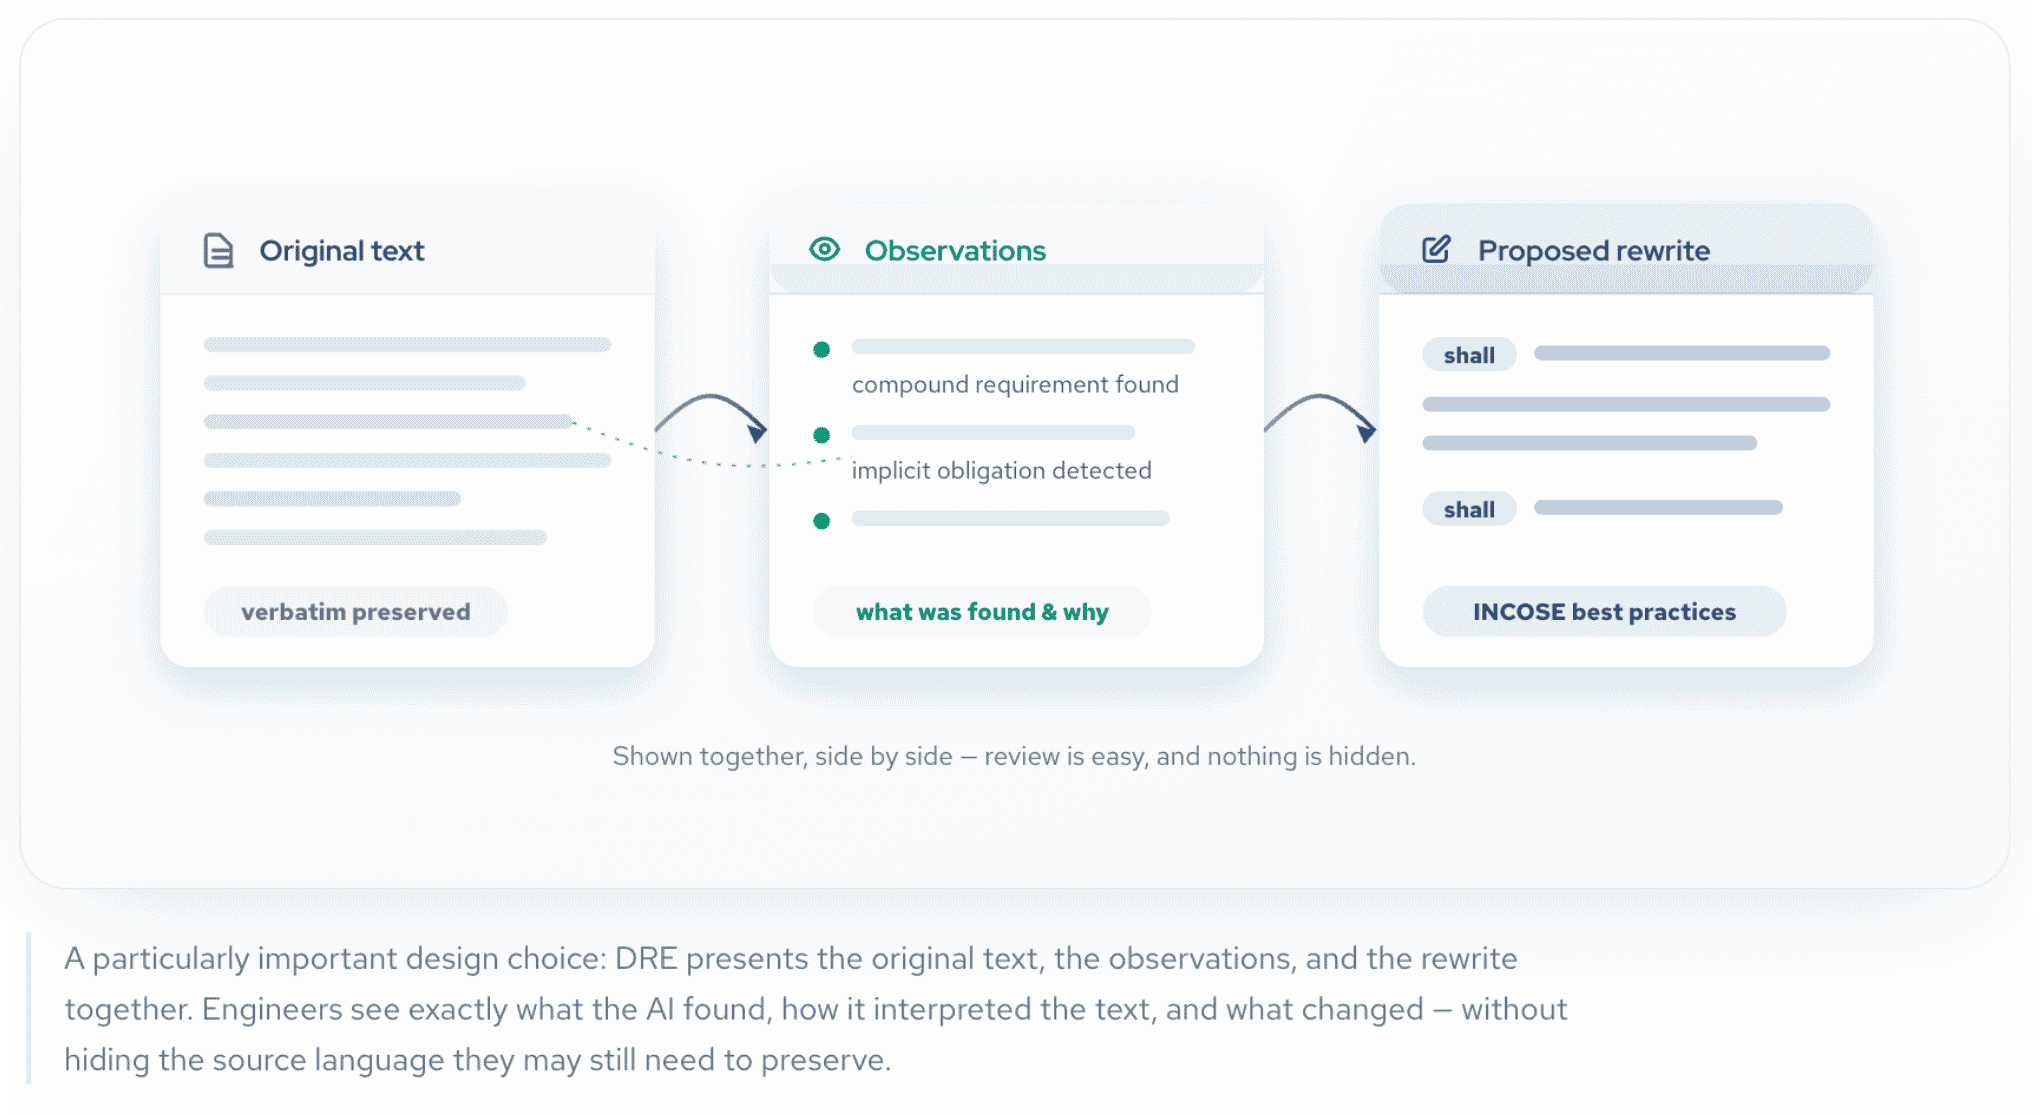
Onze Document Requirements Extractor (DRE) scant documenten structureel en identificeert eisen, afhankelijkheden, aannames, verplichtingen en impliciete verwachtingen. Het is ontworpen om concepten te lezen, niet alleen zinnen, en om brondocumenten om te zetten in gestructureerde output die downstream-tools zoals DOORS, Relatics en aanverwante eisen-management processen kan voeden.
Vanuit hallucinatierisico bekeken wordt DRE beschermd door geavanceerde taakspecifieke prompting, modelkeuze die past bij extractie- en herschrijfgedrag, taakscheiding en -sequencing om afleiding te beperken, en traceerbaarheid via toelichting.
Complexe analyse opdelen in kleinere, controleerbare stappen
Onze Requirements Quality Analyser (RQA) heeft een ander karakter dan DRE, omdat het kwaliteit beoordeelt, problemen signaleert en verbeteringen voorstelt. Het combineert deterministische hard-rule-checks met semantische analyse, en toetst requirementkwaliteit aan INCOSE-opgestelde criteria: vaagheid, absolute termen, samengestelde eisen en andere kwaliteitsproblemen.
Wat het meest telt voor hallucinatiebeheersing is de structuur van de workflow. RQA deelt de analyse op in kleinere stappen met interne en gerapporteerde traceerbaarheid bij elke stap. Die compartimentering is cruciaal, want RQA kan meer dan 15 afzonderlijke analyses omvatten voordat het gaat van analyse → observatie → verbetering → verbeterde output.
Als dat allemaal in één losse prompt zou gebeuren, zou de output veel moeilijker te vertrouwen zijn. Door het op te delen in kleinere stappen verkleint Basewise de kans op niet-onderbouwde sprongen in de redenering en wordt de redenering beter inspecteerbaar voor de gebruiker.
Sterk gegrond, retrieval-first en fasebewust
REF is de meest uitgesproken bewijsgedreven app op het platform. Het voert live retrieval uit over door de gebruiker aangeleverde documenten en produceert een verificatieregister met het gevonden bewijs, het brondocument, de locatie in het document, de score, het verdict en een onderbouwde toelichting. Verdicts zijn onder andere Pass, Partial en Fail.
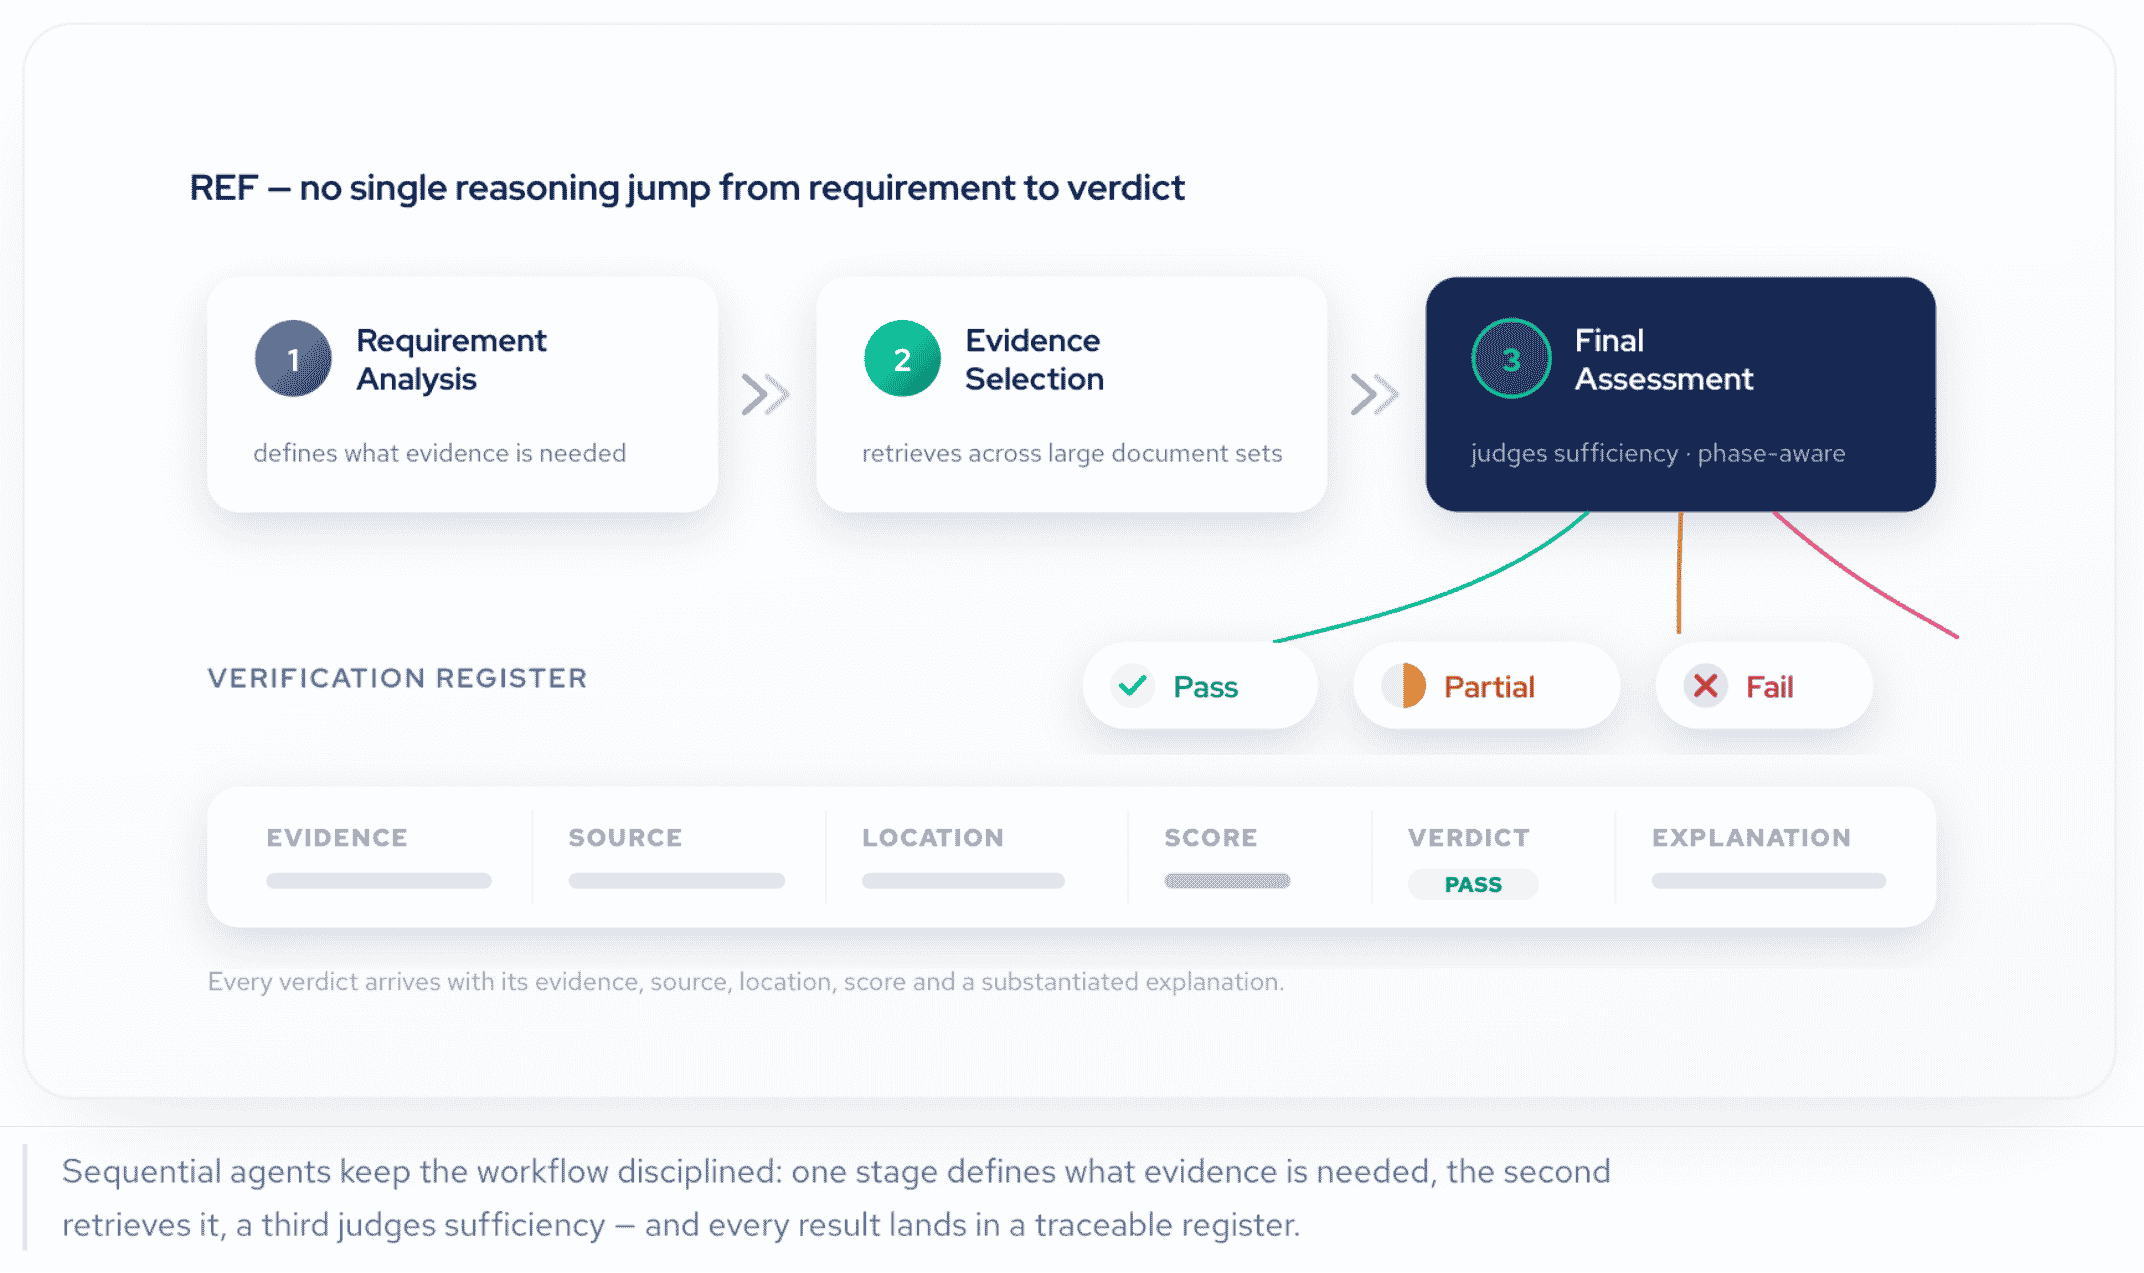
REF is ook fasebewust. De bewijsdrempel verandert afhankelijk van of het project in de ontwerp- of de uitvoeringsfase zit. Dat is belangrijk, omdat een veelvoorkomend hallucinatiepatroon is dat plannen of intenties worden voorgesteld alsof het al geleverd bewijs is. REF is ontworpen om dat te vermijden door bewijs in context te beoordelen.
In deze app, meer dan in welke andere ook, komt de betrouwbaarheid van Basewise voort uit de combinatie van retrieval-engineering, gestructureerd redeneren, bronvermelding, confidence scoring en herleidbare output.
Wat er gebeurt als Basewise onzeker is
This is one of the most important parts of the design.
Als Basewise niet zeker is, presenteert het niet simpelweg een gepolijst antwoord in de hoop dat de gebruiker het accepteert. In plaats daarvan kan het de casus escaleren naar complexere redeneerloops en aanvullende evaluaties. Blijft de onzekerheid bestaan, dan wordt het item gemarkeerd met een lagere confidence score en wordt de reden voor de onzekerheid zichtbaar gemaakt.
Sommige requirements of bewijssets zijn werkelijk ambigu. In die gevallen vinden mensen het materiaal vaak ook voor meerdere uitleg vatbaar. Een goed AI-systeem zou niet moeten doen alsof de ambiguïteit verdwenen is. Het zou die vroeg en duidelijk naar de oppervlakte moeten brengen.
Waar handmatige inspanning afneemt — en waar expertaandacht nog telt
In praktische zin vermindert Basewise handmatig werk door veel van de repetitieve analyse op zich te nemen die komt kijken bij:
- het extraheren van gestructureerde eisen uit brondocumenten
- het op schaal controleren van eiskwaliteit
- het voorstellen van verbeteringen
- het ophalen van bewijs over grote documentsets
- het produceren van herleidbare, review-klare output
Expertaandacht blijft essentieel voor:
- items met lagere zekerheid
- ambigu bronmateriaal
- items met concurrerende interpretaties
- beslissingen met hoge impact
- eindgoedkeuring en acceptatie
Conclusie
Basewise elimineert het hallucinatierisico niet, en we garanderen geen hallucinatie-vrije output. Wat we wél bieden is een hybride, gelaagde betrouwbaarheidsaanpak die is ontworpen om AI nuttig te maken in echte systems-engineering-workflows. Het doel is praktisch:
- hoogbetrouwbare output produceren
- die gegrond houden in bewijs en traceerbaarheid
- onzekerheid zichtbaar maken
- de hoeveelheid handmatige engineering-inspanning verminderen
- de uiteindelijke beslissing bij de expert laten
In de praktijk betekent dat dat systems engineers meestal snel door de output met hoge zekerheid heen gaan en meer tijd besteden aan het kleinere aantal lastige of ambigue gevallen. Dat is precies waar de inspanning van de expert het meest waardevol is.
%20doc%20=%20fitz.open(pdf_path)%20full_text%20=%20%20for%20page%20in%20doc%20full_text%20+=%20page.get_text()%20return%20full_text%20%23%20Gebruik%20%23%20print(extract_text_from_p%20(3).png)
Human-in-the-loop als ontwerpkeuze bij AI in Systems Engineering
Waarom brede AI niet volstaat voor eisenmanagement